组学研究中错误发现率控制的统一实用分类法
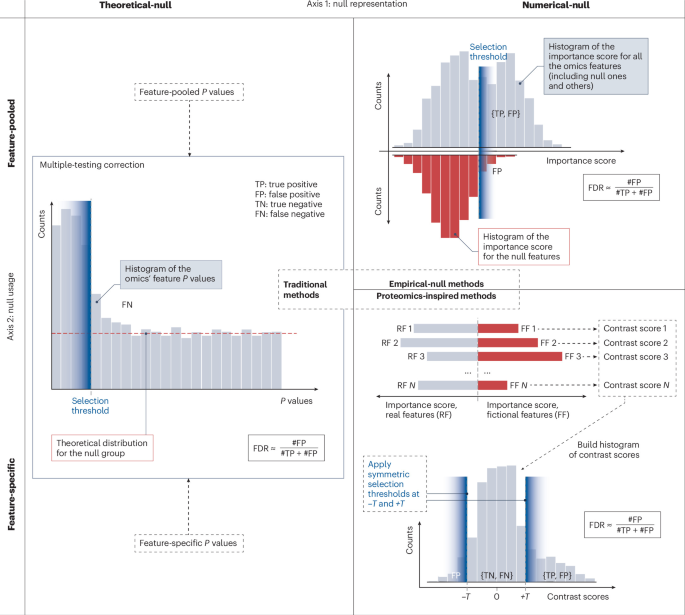
做基因和蛋白质研究的科学家们,常常为挑选哪种统计方法来防止统计错误而头疼。最近《自然·生物技术》发表的一篇评论文章,提出了一个 2×2 的矩阵工具。这个分类框架能帮研究人员根据自身的 数据和实验设计,挑选出最合适且严谨的统计方法。
原文配图暂不可用
背景
在基因组学和质谱等组学研究中,科学家们往往会同时对成千上万个生物学特征进行检测,这就很容易出现误报(假阳性)。虽然学术界开发了各种统计方法来控制错误发现率,但由于它们依赖的假设各不相同,研究人员在实际挑选时常常无所适从。
细节与影响
为了解决这个痛点,作者在文章中提出了一套基于 2×2 矩阵 的实用分类法。据作者介绍,该框架旨在指导基于基因测序和质谱的组学研究人员,帮助他们根据具体的 实验设计,理清思路并挑选出最合适的 错误发现率控制方法,或者换用更严谨的替代方案。
查看筛选依据
研究论文阶段未明确
重要性 14/100
信号20结构20影响0可信度85热度30
关于这篇简报
- 内容类型
- 研究摘要
- 信源类型
- 媒体报道
- 原文发布时间
- 处理方式
- AI 辅助发现、翻译、摘要、分类与评分;编辑标准和纠错由编辑部维护。
- 核验边界
- 保留原始链接与发布信息;除非特别说明,本简报不构成独立事实核查。
- 发布方
- Polyemergence Editorial Desk · PolyEmergence Pte Ltd.
- 利益冲突
- 无已声明的财务或商业利益冲突。