算力军备大升级:超节点从PPT走向规模化交付
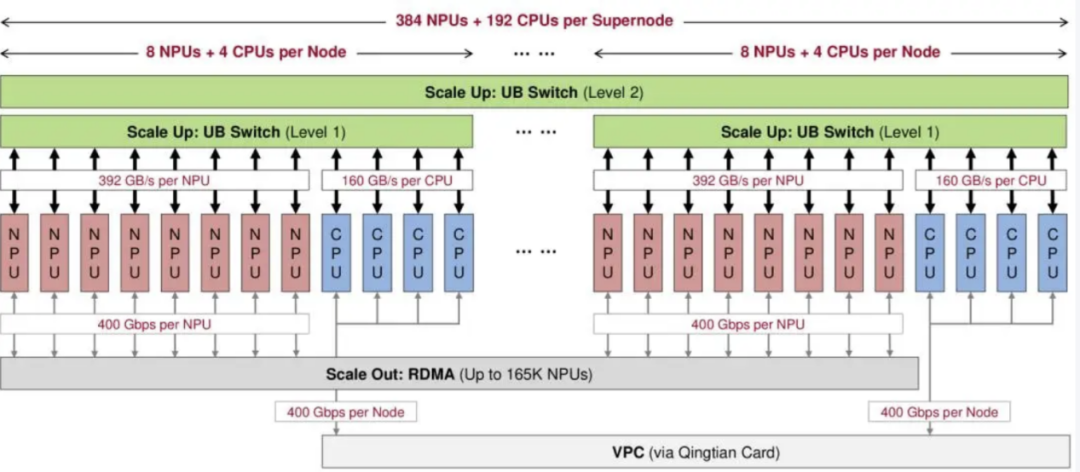
大模型的军备竞赛变天了,过去靠简单堆砌显卡的“加卡”时代正在翻篇,行业迎来了超节点的新阶段。简单来说,就是把成百上千张芯片用极高速的网线和总线死死缝在一起,让它们变成一块“巨型显卡”,彻底解决过去多卡互等、算力闲置的顽疾。这场变革标志着算力竞争不再只拼单芯片性能,而是拼整套系统的集成与交付能力。
原文配图暂不可用
从堆卡走向堆系统的工程突围
过去训练大模型,大家习惯把几万张显卡分散在不同服务器里靠以太网连接,但跨服务器的通信延迟导致大量算力花在了互相等待上。超节点的解法是把几十甚至上千张卡放进一个紧耦合的域里,通过高速总线直连,让整台机器的内存可以跨卡直接访问,把通信延迟从微秒级压缩到纳秒级,大幅提升了集群线性加速比。
互联协议与产业链的重构
超节点的核心壁垒不再是单纯的芯片算力,而是卡与卡之间的“路”宽不宽。英伟达、华为、阿里等巨头纷纷推出自研互联协议和近封装光学技术,争夺下一代基础设施的标准定义权。同时,预制化的超节点设计把交付周期从半年缩短到了十几天,直接带动了液冷技术、高速连接器以及交换芯片等整个产业链的爆发。
国产算力的系统性补课
面对先进制程的现实约束,国内厂商通过超节点设计用系统集成来弥补单芯片的短板。尽管未来当集群规模继续扩大时仍会面临新的通信挑战,但超节点走向批量交付,意味着算力竞争的主战场已经彻底从单纯拼芯片代际转移到了系统集成能力的较量上。
查看筛选依据
媒体报道阶段未明确
重要性 87/100
信号88结构90影响82可信度88热度85
关于这篇简报
- 内容类型
- 新闻摘要
- 信源类型
- 媒体报道
- 原始来源
- TMTPost 钛媒体 ↗
- 原文发布时间
- 处理方式
- AI 辅助发现、翻译、摘要、分类与评分;编辑标准和纠错由编辑部维护。
- 核验边界
- 保留原始链接与发布信息;除非特别说明,本简报不构成独立事实核查。
- 发布方
- Polyemergence Editorial Desk · PolyEmergence Pte Ltd.
- 利益冲突
- 无已声明的财务或商业利益冲突。