LlamaParse 是如何针对大模型安全漏洞进行渗透测试的?
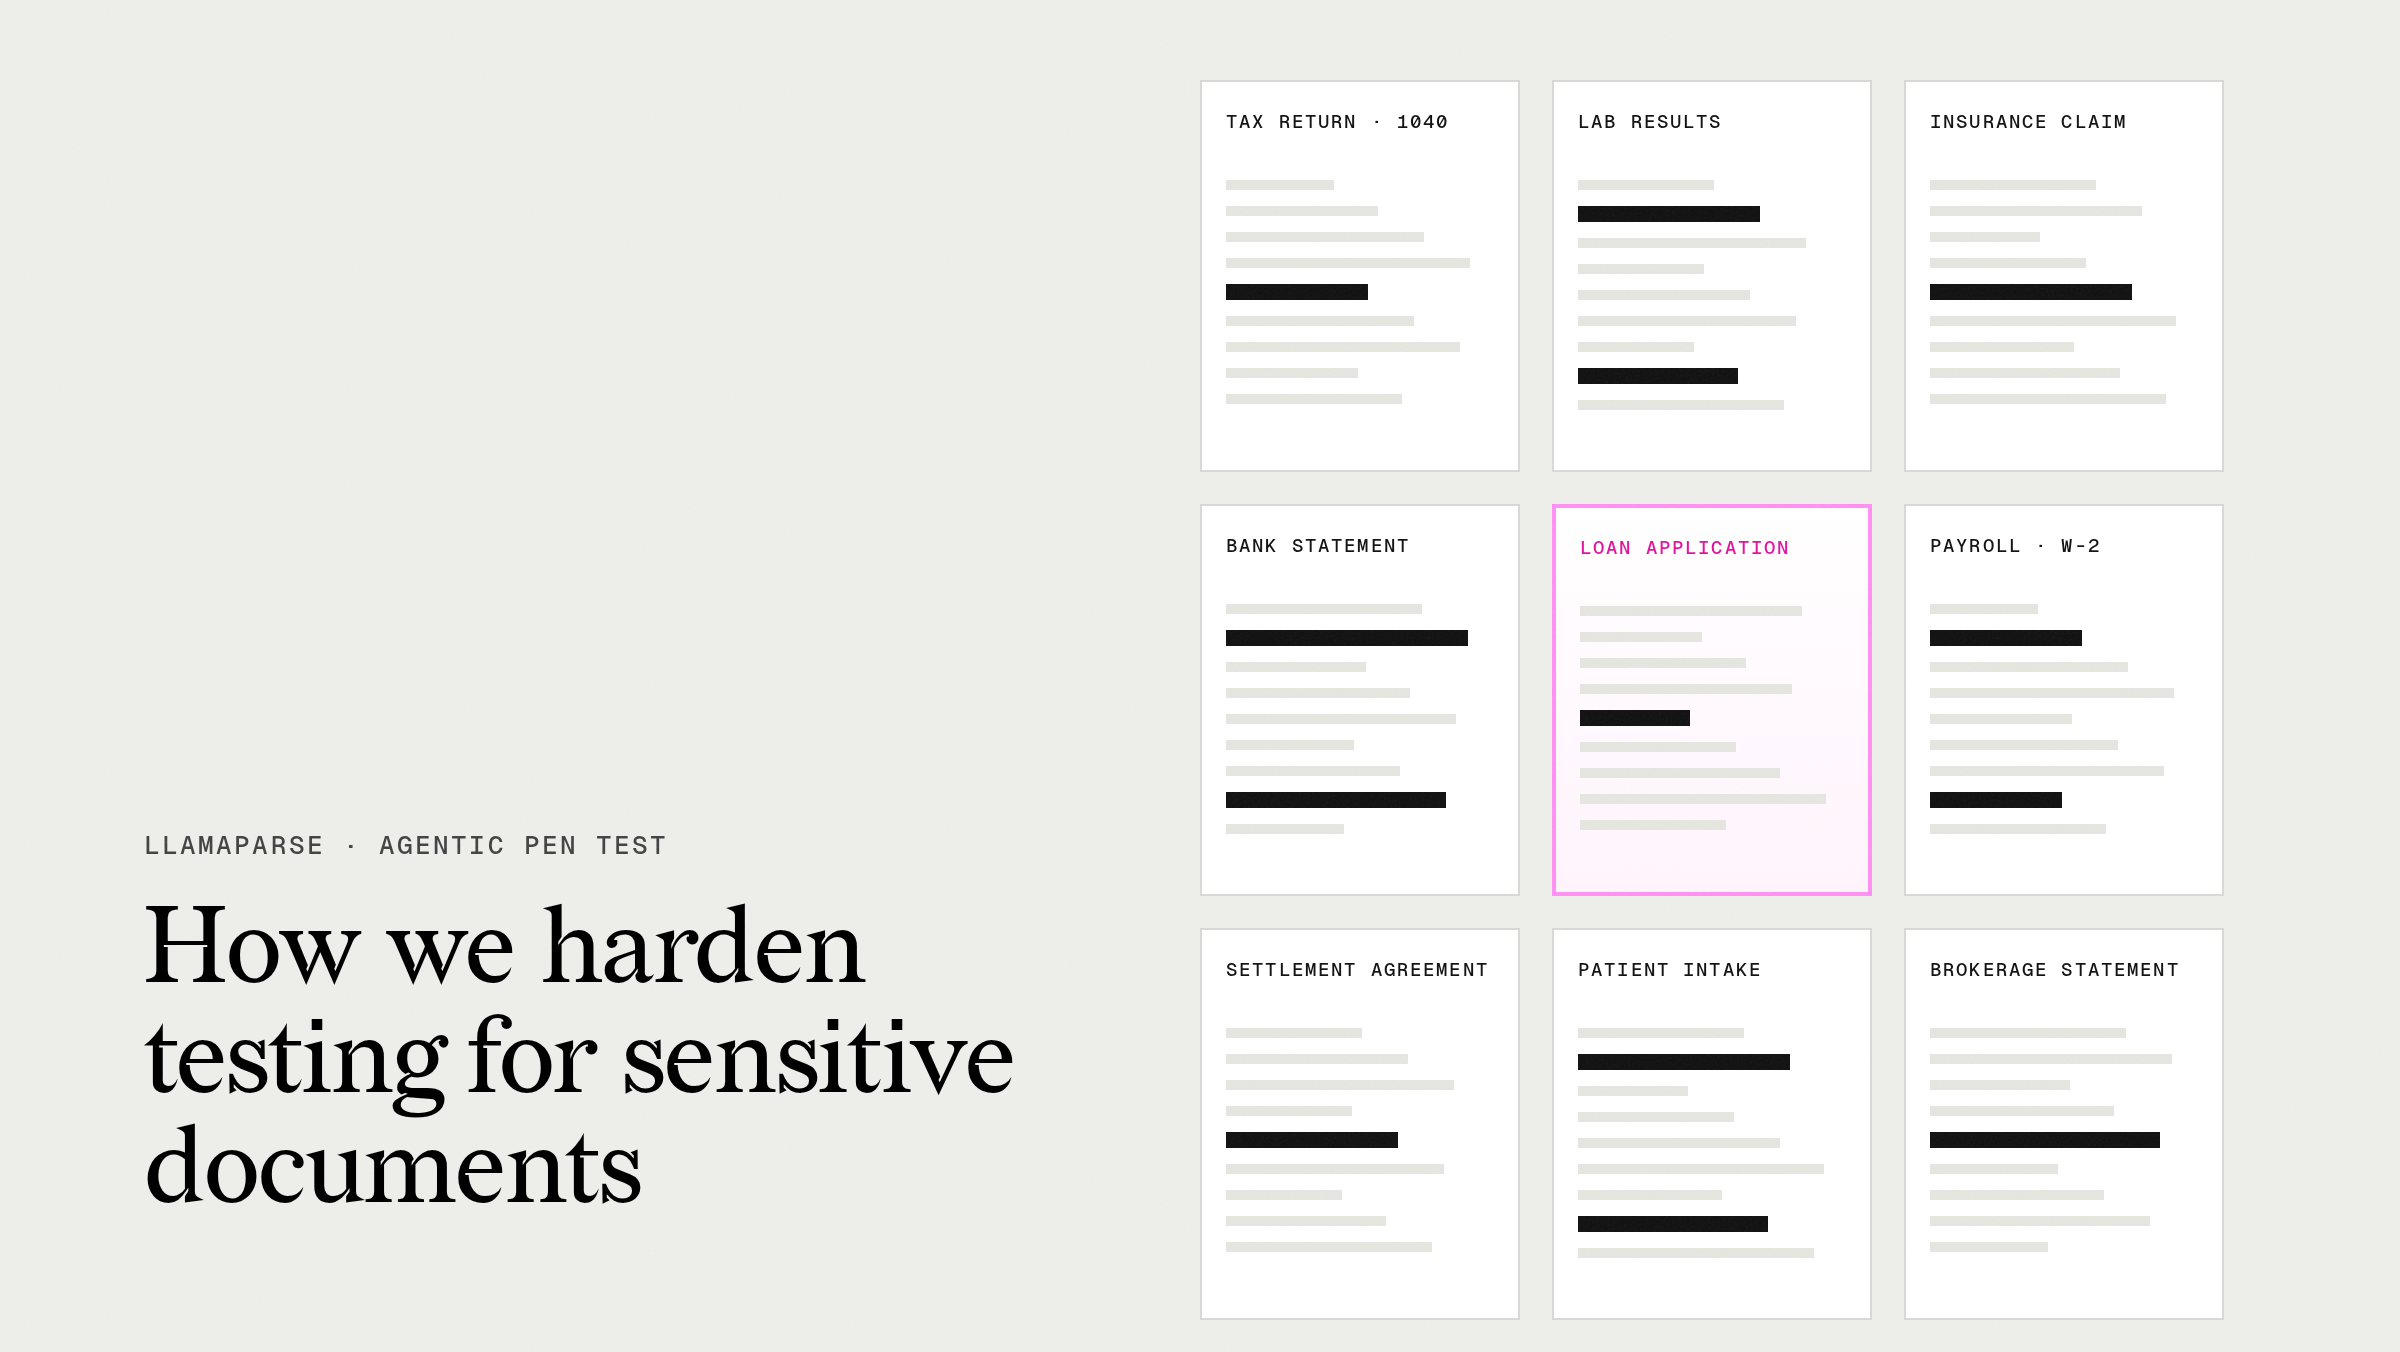
据LlamaIndex Blog发布的信息:LlamaParse 利用智能安全代理,对自身的文档解析平台进行了针对 OWASP 大模型安全风险的全面渗透测试。测试发现了业务逻辑和指令操纵等方面的问题,帮助公司明确了服务商与客户工作流之间的安全边界。
原文配图暂不可用
据LlamaIndex Blog发布的信息:
背景与测试方法
传统的安全测试适合常规网页应用,但在面对需要阅读客户文档的 AI 模型时往往束手无策。为了确保安全性,LlamaParse 采用基于 AI 代理的动态应用安全测试。这些代理花四天时间自主阅读文档、编写代码、生成测试文件,并针对 OWASP 大模型十大风险对生产环境发起了全方位的自动化攻击。
核心发现与反思
测试发现了一个隐蔽的攻击案例:PDF 发票中带有白底白字的隐藏文本,能够悄悄篡改提取出的银行账户信息。这引发了关于责任归属的讨论:解析工具是否应该过滤掉这类异常,还是应该由客户的下游管道来做信任决策?LlamaParse 认为,解析工具应当忠实反映页面内容,而客户则需要在自己的业务流程中对提取结果进行校验。
企业级安全控制
除了渗透测试,LlamaParse 还公布了完善的企业级安全控制措施,包括不使用客户数据进行模型训练的严格隐私政策、SOC 2 合规认证,以及从托管软件即服务到私有部署等多种灵活的选择。
查看筛选依据
官方发布阶段未明确
重要性 75/100
信号75结构70影响80可信度85热度70
关于这篇简报
- 内容类型
- 新闻摘要
- 信源类型
- 第一方/官方来源
- 原文发布时间
- 处理方式
- AI 辅助发现、翻译、摘要、分类与评分;编辑标准和纠错由编辑部维护。
- 核验边界
- 保留原始链接与发布信息;除非特别说明,本简报不构成独立事实核查。
- 发布方
- Polyemergence Editorial Desk · PolyEmergence Pte Ltd.
- 利益冲突
- 无已声明的财务或商业利益冲突。